- Published on
Roofline 性能模型
- Authors

- Name
- Vegetog
一张 GPU 标称有很高的算力,为什么程序实际跑出来的速度可能低很多?有时问题不在计算单元,而在于数据送得不够快。
Roofline(屋顶线)模型就是用来分析这个问题的:一个任务的性能上限,主要受到算力限制,还是数据搬运速度限制?
可以把 GPU 想成一个加工车间:计算单元负责加工,显存负责供应原料。加工能力再强,原料跟不上,也只能等待。
本文先讨论显存与 GPU 芯片之间的数据搬运,也就是显存带宽对应的 Roofline。CPU 与 GPU 之间的 PCIe 传输不计入这里的显存流量,需要另外分析。全文硬件数字都是教学假设,示例结果也不是某张真实显卡的测试报告。
1. 先分清工作量和速度
理解 Roofline,只需要先认识下面几个量。
| 符号 | 含义 | 单位 |
|---|---|---|
| F | 计算量:总共做多少次浮点运算 | FLOPs |
| D | 搬运量:总共从显存读、向显存写多少数据 | Byte |
| t | 完成任务所需的时间 | s |
| P | 计算性能:每秒完成多少次浮点运算 | FLOP/s |
| B | 显存带宽:每秒最多能搬多少数据 | Byte/s |
| I | 计算强度:每搬 1 Byte,支撑多少次计算 | FLOP/Byte |
FLOPs 是工作量,FLOP/s 是速度。 例如,100 亿次运算是计算量;每秒完成 100 万亿次运算,则是 100 TFLOP/s 的计算性能。
本文统一使用十进制单位:1 GB = 10⁹ Byte,1 TB = 10¹² Byte,1 TFLOP/s = 10¹² FLOP/s。
计算强度(Arithmetic Intensity)定义为:
它衡量的是“搬一份数据能用来算多少”,不是程序有多复杂,也不是显卡自身的参数。同一个程序改变输入形状、batch size 或数据复用方式,计算强度就可能变化。
这里的 D 是数据流量,不能直接拿显存占用来替代。一个 1 GB 的矩阵,如果从显存完整读取两次,就产生约 2 GB 的读取流量;如果第二次命中片上缓存,就不一定再次产生这 1 GB 显存流量。写回的数据也要计入。
2. 从一个耗时例子理解瓶颈
假设一张 GPU 在当前使用的精度和计算模式下,峰值算力为 100 TFLOP/s,显存带宽为 1 TB/s。
一个任务需要完成 100 亿次浮点运算,并在显存与芯片之间搬运 1 GB 数据。
只看计算能力,至少需要:
只看搬运能力,至少需要:
计算只需要 0.1 ms,但数据搬运至少需要 1 ms。即使计算与搬运能够充分重叠,整个任务也不可能快于 1 ms。
这时,性能上限只有:
显卡明明有 100 TFLOP/s 的算力,这个任务的上限却只有 10 TFLOP/s,因为数据供应跟不上。
如果只把算力翻倍,计算时间从 0.1 ms 降到 0.05 ms,但搬运仍需要 1 ms,这个理想下界不会因此减半。如果带宽翻倍,搬运下界才会从 1 ms 降到 0.5 ms。真实程序能否获得相应加速,还要测量。
3. Roofline 的核心公式怎么来的
设峰值算力为 P_peak,显存带宽为 B。整个任务的时间至少要同时满足计算和搬运的要求:
这里取 max,是在写一个乐观的时间下界,并不意味着所有程序都能让计算与搬运完全重叠。无法重叠的部分、启动和同步等开销,都可能使真实耗时更长。
因为实际性能 P_actual = F/t,所以:
代入 I = F/D,就得到 Roofline 的核心公式:
为什么带宽要乘计算强度?看单位就能理解:
每秒送来多少数据 × 每份数据支撑多少计算 = 数据供应能够支撑的计算速度。 但这个速度还不能超过计算单元自身的峰值,因此要取两个数里较小的那个。Roofline 用这种方式描述性能上限,而不是承诺真实程序一定跑到这条线。NERSC Roofline 说明
4. 横纵坐标分别是什么意思
Roofline 图的横坐标是计算强度 I,单位为 FLOP/Byte;纵坐标是计算性能 P,常用 GFLOP/s 或 TFLOP/s。
- 横坐标越大,表示每搬一份数据,能支撑更多计算。它不是数据量,也不是运行时间。
- 纵坐标越大,表示每秒完成的计算越多。它不是总计算量,也不是 GPU 利用率百分比。
- 屋顶线上的高度是该计算强度下的性能上限;一个实际程序对应的点,则是横坐标 F/D、纵坐标 F/t。
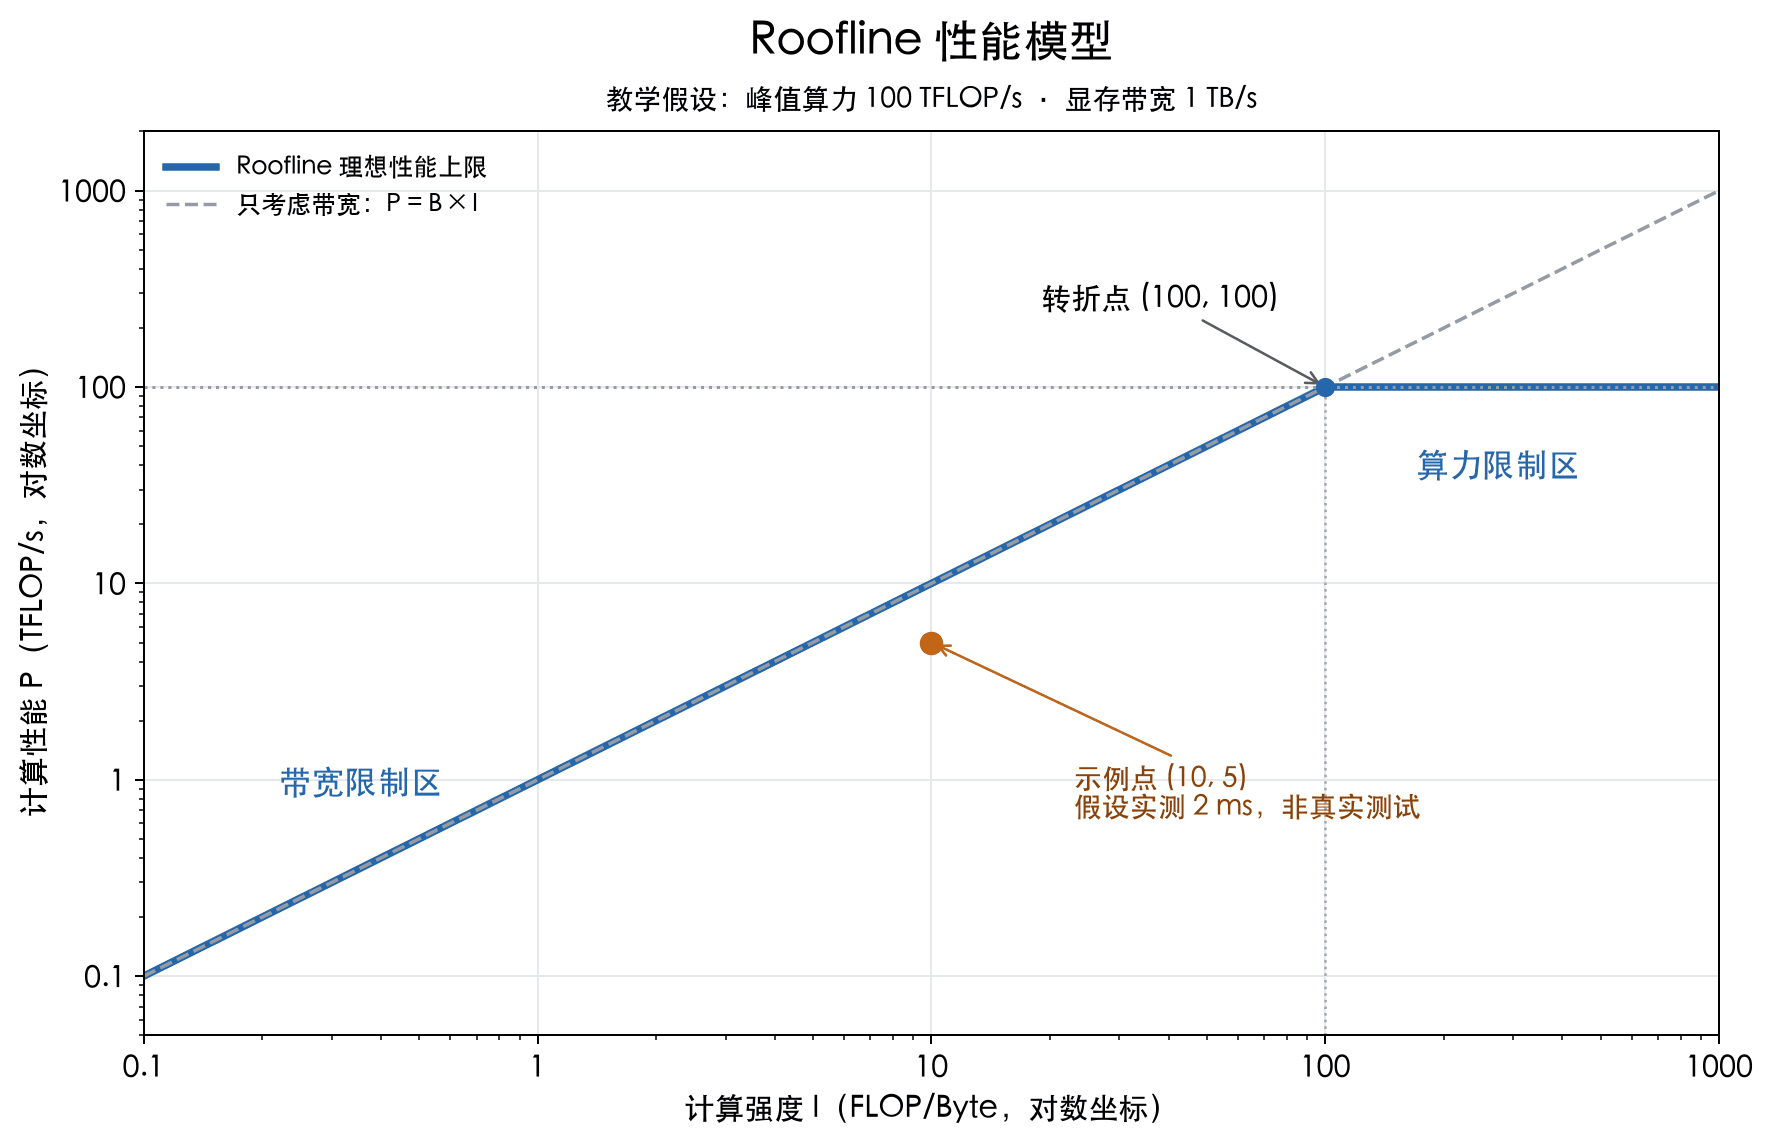
图中 GPU 参数为教学假设;橙色点是“如果测得 2 ms”时的示意点,不是真实 benchmark。横纵轴都采用对数坐标,因此 1、10、100、1000 这样的刻度按相同间距排列。
5. 为什么屋顶先上升,后面变平
先只考虑带宽,仍然假设每秒最多搬 1 TB 数据。
| 计算强度 I | 带宽能够支撑的计算速度 B × I | 同时考虑 100 TFLOP/s 算力后的上限 |
|---|---|---|
| 1 FLOP/Byte | 1 TFLOP/s | 1 TFLOP/s |
| 10 FLOP/Byte | 10 TFLOP/s | 10 TFLOP/s |
| 100 FLOP/Byte | 100 TFLOP/s | 100 TFLOP/s |
| 200 FLOP/Byte | 200 TFLOP/s | 100 TFLOP/s |
| 1000 FLOP/Byte | 1000 TFLOP/s | 100 TFLOP/s |
在前半段,数据供应还不够。计算强度提高,相同流量就能支撑更多计算,所以上限沿着 P = B × I 上升。这是带宽限制区。
在后半段,数据供应已经能满足计算单元。计算强度继续提高,计算单元也不能超过每秒 100 万亿次运算,所以上限保持在 100 TFLOP/s。这是算力限制区。
X 涨而 Y 不涨,意味着数据供应不再是这两个上限中更紧的那个,计算单元自身的速度成了上限。
例如,当 I = 100 FLOP/Byte 时,要维持 100 TFLOP/s,需要 1 TB/s 带宽;当 I = 200 FLOP/Byte 时,维持同样速度只需要 0.5 TB/s。数据复用更充分了,但计算单元没有因此变快。
两段线的交点叫转折点(Ridge Point):
所以,“计算强度高不高”要和具体硬件的转折点比较。同一个任务放到算力与带宽比例不同的 GPU 上,所处区域可能不同。
常见的双对数图里,P = B × I 仍然是一条直线,因为 log P = log B + log I,斜率为 1;P = P_peak 则是一条水平线。两种限制取较低的一条,就形成了屋顶。
6. 哪些数据查表,哪些自己计算
硬件能提供多少资源,通常查规格表;程序要消耗多少资源,则要分析代码或测量。
| 数据 | 获取方法 | 需要注意什么 |
|---|---|---|
| 峰值算力 P_peak | GPU 官方规格表 | 匹配精度、Tensor Core 或普通计算路径、稠密或稀疏模式 |
| 显存带宽 B | GPU 官方规格表 | 查 Memory Bandwidth,不要拿 PCIe 或 NVLink 带宽替代 |
| 计算量 F | 按算法和输入形状计算,或用工具统计 | 例如矩阵乘法约为 2MKN;比较时保持计数口径一致 |
| 搬运量 D | 根据读写行为估算,或用工具测量 | 同时计入读写、重复搬运和缓存效果 |
| 计算强度 I | 用 F/D 计算 | 属于任务及其实现,不是显卡的固定参数 |
| 耗时 t | 实际运行并计时 | 明确计时的是单个 kernel 还是整个任务 |
| 实际性能 P_actual | 用 F/t 计算 | F 和 t 必须来自同一段工作 |
比如,普通 FP32 数组加法不能直接拿 FP16 Tensor Core 的宣传算力作为自己的峰值。规格表描述的是理论能力;如果需要更贴近实际机器,可以用微基准测量可达到的算力和带宽,再构建 Roofline。
7. 不运行程序,也能先做一次粗分析
“查硬件参数,再手算计算量和理想搬运量”,指的是先判断可能的瓶颈方向,并不是直接得到了真实运行结果。
以大数组加法为例:
C[i] = A[i] + B[i];
假设 A、B、C 是不同数组,元素都是 float32,每个数占 4 Byte;输入起初位于显存中。忽略额外事务开销,每个输入只读取一次,每个输出只写入一次。
| 每处理一个元素 | 计算量 | 搬运量 |
|---|---|---|
| 读取 A[i] | 0 | 4 Byte |
| 读取 B[i] | 0 | 4 Byte |
| 相加 | 1 FLOP | 0 |
| 写入 C[i] | 0 | 4 Byte |
| 合计 | 1 FLOP | 12 Byte |
所以理想计算强度为:
处理 N 个元素时,计算量是 N,搬运量是 12N,比值仍为 1/12。数组变大,并不自动意味着计算强度变大。
若匹配的 FP32 算力为 100 TFLOP/s,显存带宽为 1 TB/s,带宽最多只能支撑:
它远低于 100 TFLOP/s。第一轮判断就是:这个大数组加法的 Roofline 上限由显存带宽决定,值得优先检查访存效率。单纯提高计算峰值,帮助通常有限。
但如果数组很小,启动开销可能更加突出;如果数据已经在缓存中,显存流量也会不同。上述结论要放回给定条件下理解。
8. 屋顶下面的点怎么看
回到“100 亿次运算、1 GB 搬运”的任务:I = 10 FLOP/Byte,Roofline 上限为 10 TFLOP/s。
假设实际运行测得耗时为 2 ms,那么:
这个点的坐标就是 (10, 5),达到了对应 Roofline 上限的 50%。它只达到显卡峰值算力的 5%,但不能仅凭这个比例就认定实现很差。
另一方面,点落在左侧区域,也不证明程序已经跑满了显存带宽。还可能存在不连续访存、并行度不足、依赖等待等问题。若统计整个任务,还可能包含 kernel 启动、同步和 CPU 调度开销。
点离屋顶越远,说明这个简单模型还不足以解释全部耗时,需要进一步定位。Nsight Compute 可以收集 kernel 的运算、内存流量和执行相关指标,并提供 Roofline 分析。不同缓存层还可以建立各自的 Roofline,但带宽和流量必须对应同一层。NVIDIA Nsight Compute 文档
实际分析时,可以先选择一个主要 kernel,预热后用 CUDA Event 等方式测量其执行时间,并确认计时边界。不要把异步启动函数在 CPU 上返回的时间,误当成 GPU 完成计算的时间。
9. 为什么矩阵乘法更容易复用数据
考虑一个线性层中的矩阵乘法:
每个输出元素要进行约 K 次乘加;一次乘加按 2 次浮点运算计算,所以总计算量约为:
假设输入、权重和输出都用 FP16 存储,每个元素 2 Byte,不读取旧输出,也暂不考虑偏置。若 X 和 W 各从显存读取一次,Y 写回一次,则理想搬运量为:
计算强度估计为:
这是一种理想数据复用估计;真实 kernel 的分块方式、缓存容量和实际流量可能使结果不同。NVIDIA 矩阵乘法指南
当权重矩阵 W 的搬运占主导,也就是 KN 远大于 MK + MN 时,可以进一步近似:
直觉很简单:同一份权重读进来,被更多行输入使用,搬运就更划算。
例如 K = N = 4096,按上面的理想公式,M = 1 时计算强度约为 1 FLOP/Byte;M = 128 时约为 120.5 FLOP/Byte。后者不是精确的 128,因为输入和输出的流量仍然要算。
10. 用它理解 LLM 的 Prefill 和 Decode
对线性层而言,可以把 M 理解为这次矩阵乘法一起处理的 token 行数。
单请求 Decode 每步处理一个新 token,通常 M 很小。同一份权重读进来,只服务很少的 token,权重复用有限,因此线性层容易受到权重搬运的限制。
Prefill 可以一次处理许多输入 token;批处理 Decode 也可以同时处理多个请求的新 token。如果实现能够复用权重,同一份权重就可以服务更多 token,计算强度随之提高,更有机会接近算力限制区。
这是根据前面的矩阵乘法模型得到的解释,不是“Prefill 永远算力受限、Decode 永远带宽受限”的定律。完整推理还包含 Attention、KV cache、归一化、通信和调度;上下文长度、batch size、量化方式和硬件都会影响瓶颈。增大 batch 通常关注总吞吐,并不保证单个请求延迟降低。
11. 用 Roofline 指导优化时,先问三个问题
第一,当前任务的计算强度在哪里?用匹配的算力和带宽求出转折点,再比较 F/D,先看是带宽上限更低,还是算力上限更低。
第二,实际点离屋顶多远?固定计算强度时,让访存更连续、增加有效并行度等措施,可能使点向上接近屋顶。减少重复读写、通过分块或算子融合复用数据,则可能减少 D,使点向右移动。具体是否有效,需要验证。
第三,真实耗时有没有减少?不要为了提高 I 或 FLOP/s 而增加无用计算。若计算量 F 也变大,即使每秒计算更多,完成任务的时间也未必更短。已经进入水平段,也不表示减少数据搬运完全没有价值,只是最简单的 Roofline 算力上限不再上升。
算力限制区可以优先检查是否使用了合适的计算指令、矩阵形状和并行实现;带宽限制区可以优先检查数据复用与访存效率。任务很小时,还应先判断是不是启动和延迟开销占主导。NVIDIA GPU 性能背景说明
做第一轮分析时,只需要完成这条流程:
确定任务范围、输入形状、精度和计算模式
→ 查对应峰值算力与显存带宽
→ 估算计算量 F 和理想搬运量 D
→ 计算 I = F / D
→ 求上限 min(P_peak, B × I)
→ 实测耗时 t,计算 P_actual = F / t
→ 比较实际点与屋顶,再定位具体原因
Roofline 最有用的地方,是让“这段代码为什么慢”有了一个可以手算、可以测量、也可以进一步验证的起点。